对于许多个人博客或小型 content-focused 网站来说,站内搜索一直是个尴尬的存在:直接跳 Google 搜索体验不好且有时抓取不及时,部署传统的 Elasticsearch 维护成本和内存开销太高,而普通的数据库模糊查询(LIKE)又太笨拙,无法理解语义。
作者 mazrean 在运营 Go Proposal 动态汇总网站时,探索出了一套月均成本近乎为 $0、且搜索质量甚至优于 Google 的站内搜索架构。本文将这套方案拆解为可复用的实践步骤,供开发者参考。
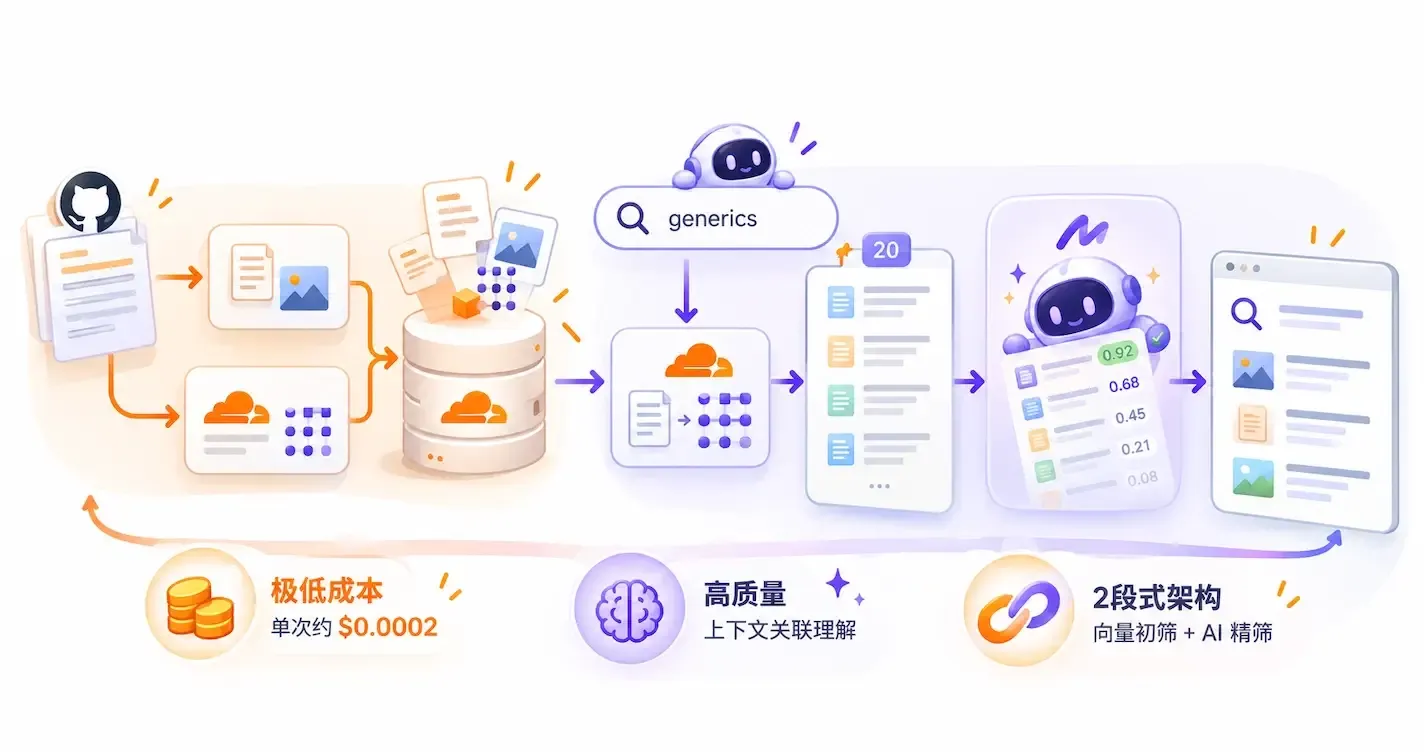
一、 核心思路:向量初筛 + 判定模型精筛
直接让 LLM 读取全站文章进行分析开销极大,而单纯依赖向量搜索又容易混入“字面相关但语义无关”的噪声。本方案的核心在于分工协作:
- 向量检索(初筛):利用免费/低成本的向量模型快速找出候选文章。
- Jev 判定模型(精筛/重排序):利用专门做“结构化判定”的轻量 AI 模型(Jev)筛选出真正相关的结果。
1[ 用户输入查询 ]2 │3 ▼4[ Cloudflare Vectorize (bge-m3 向量匹配) ] ──► 快速取出 前 20 个候选文章5 │6 ▼7[ TypeSafe AI Jev (Noul 判定) ] ──► 逐一判定“是否真正相关”8 │9 ▼10[ 过滤 (相关度 ≥ 0.2) 并降序排列 ] ──► 返回最终高质量搜索结果
二、 方案构建步骤
步骤 1:静态内容的向量化与存储(构建索引)
当你的网站内容更新时(例如通过 GitHub Actions 自动化构建时):
- 提取内容:提取文章的标题、摘要或核心文本。
- 生成 Embeddings:调用 Cloudflare Workers AI 上的
bge-m3模型将文本转化为向量。 - 入库存储:将向量及其元数据(标题、URL、摘要)存入 Cloudflare Vectorize 向量数据库。
💡 启发:将向量生成放在 CI/CD 构建阶段(静态更新),避免了在用户搜索时实时生成向量,既节省时间又节省算力成本。
步骤 2:初筛阶段(向量搜索)
当用户在前端输入关键词(如 generics)时:
- 同样调用
bge-m3模型将搜索词转化为向量。 - 在 Vectorize 中进行余弦相似度匹配,取出前 20 个最相似的候选结果。
步骤 3:精筛阶段(Jev 深度相关性判定)
普通的向量搜索往往只匹配词义接近度,无法理解复杂的行业背景或上下文逻辑。这一步引入 Jev:
- 什么是 Jev? Jev 是 TypeSafe AI 提供的一类专用模型。它不生成文本,而是专门返回带置信度的结构化结果(如 0~1 的真假判定 Noul)。特点是极快(70~500 ms)、极便宜(输入 $0.042/百万 tokens,输出免费)。
- 判定逻辑:将初筛出的 20 个候选文章标题和摘要送入 Jev,向 Jev 提出判定问题:“该文章内容是否与用户的搜索意图真正相关?”
- 过滤输出:Jev 会为每篇文章返回一个 0 到 1 之间的相关度分数。保留分数在
0.2以上的结果,并按得分从高到低排序返回给前端。
三、 为什么这套方案效果更好?
1. 能精准捕捉上下文与领域知识
在实际测试中,搜索 generics(泛型)时,Google 站内搜索漏掉了一篇没有直接包含该词、但底层关联了“泛型方法”的 Go 提案(#54297)。而这套方案借由 Jev 结合领域知识理解上下文,成功将该文章检索出来,实际体验优于 Google。
2. 极致的性价比
- 单次搜索成本:约 $0.0002。
- 月度运维预估:假设网站每 10 次 PV 产生 1 次搜索,月均仅需 $0.016 左右。加上平台提供的免费额度,个人网站几乎无需付费。
四、 避坑指南与实践建议
- 注意冷启动延迟:由于 Jev 节点目前主要位于海外,连接 Cloudflare AI Gateway 时如果请求间隔较长,TCP/TLS 连接断开会导致首包延迟上升至 1 秒以上(连续请求时为数百毫秒)。若对响应速度极其敏感,需要权衡 Gateway 的使用或增加预热机制。
- 轻量化原则:不必把整篇长文喂给 Jev,只需传入“标题 + 精简摘要”,既能保证判定准确度,又能大幅降低 Token 开销。
相关文章

ABC Legal 如何借助“Managed Agents”让 1,100 名员工人人成为 AI 开发者
实践指南
本文深度解析美国法律服务巨头 ABC Legal 如何通过 Claude Managed Agents 赋能 1,100 名员工,打造“Agent 即代码”的全员 AI 自动化体系。总结企业 AI 落地、闭环调优及 ROI 严控的四步实践指南与避坑建议。

我在 2026 年如何真正用 AI 做法律实务
实践指南
一位小型精品律所合伙人的一线实战总结,讲述他如何用 Claude 把自己十几年的法律判断「编码」进 AI,让两个人的事务所具备大所级别的产能与质量。作者通过真实案例展示:相比垂直“法律 AI”工具,一个经过精心配置的通用模型如何在合同审查、尽调、研究和文书起草中重塑律师的工作流程与商业模式。